从 Loop 到 Graph Engineering 的演进思考与实战
前言
最近在看 Agent 工程相关的内容时,我发现一个很有意思的演进方向:
我们正在从 Loop Engineering,逐步走向 Graph Engineering。
一开始看到这个说法时,我的第一反应其实和很多人一样:
- Graph?
- 不就是图结构吗?
- 这和以前说的 Workflow、知识图谱、图数据库,有什么本质区别?
但继续往下看之后,我发现这件事的重点并不在“图”这个词本身,而在于一种新的工程思路:
Loop Engineering 解决的是“让 AI 自动跑起来”的问题, Graph Engineering 解决的是“让 AI 在自动运行时不要跑偏”的问题。
这篇文章,我想结合自己的理解,把这件事重新梳理一遍,尽量讲得清楚、直白、可落地一些。
先说结论:Graph 不是图结构炫技,而是治理机制升级
如果要用一句话概括我对这两个概念的理解,那就是:
- Loop Engineering:让 AI 能围绕一个目标自动执行、自我验证、自我迭代
- Graph Engineering:在多个 Loop 之间建立监督、制衡、纠偏和仲裁机制
换句话说:
Loop 更像“执行闭环”,Graph 更像“治理闭环”。
这也是为什么我会觉得 Graph Engineering 不是对 Loop 的推翻,而更像是它的升级版。
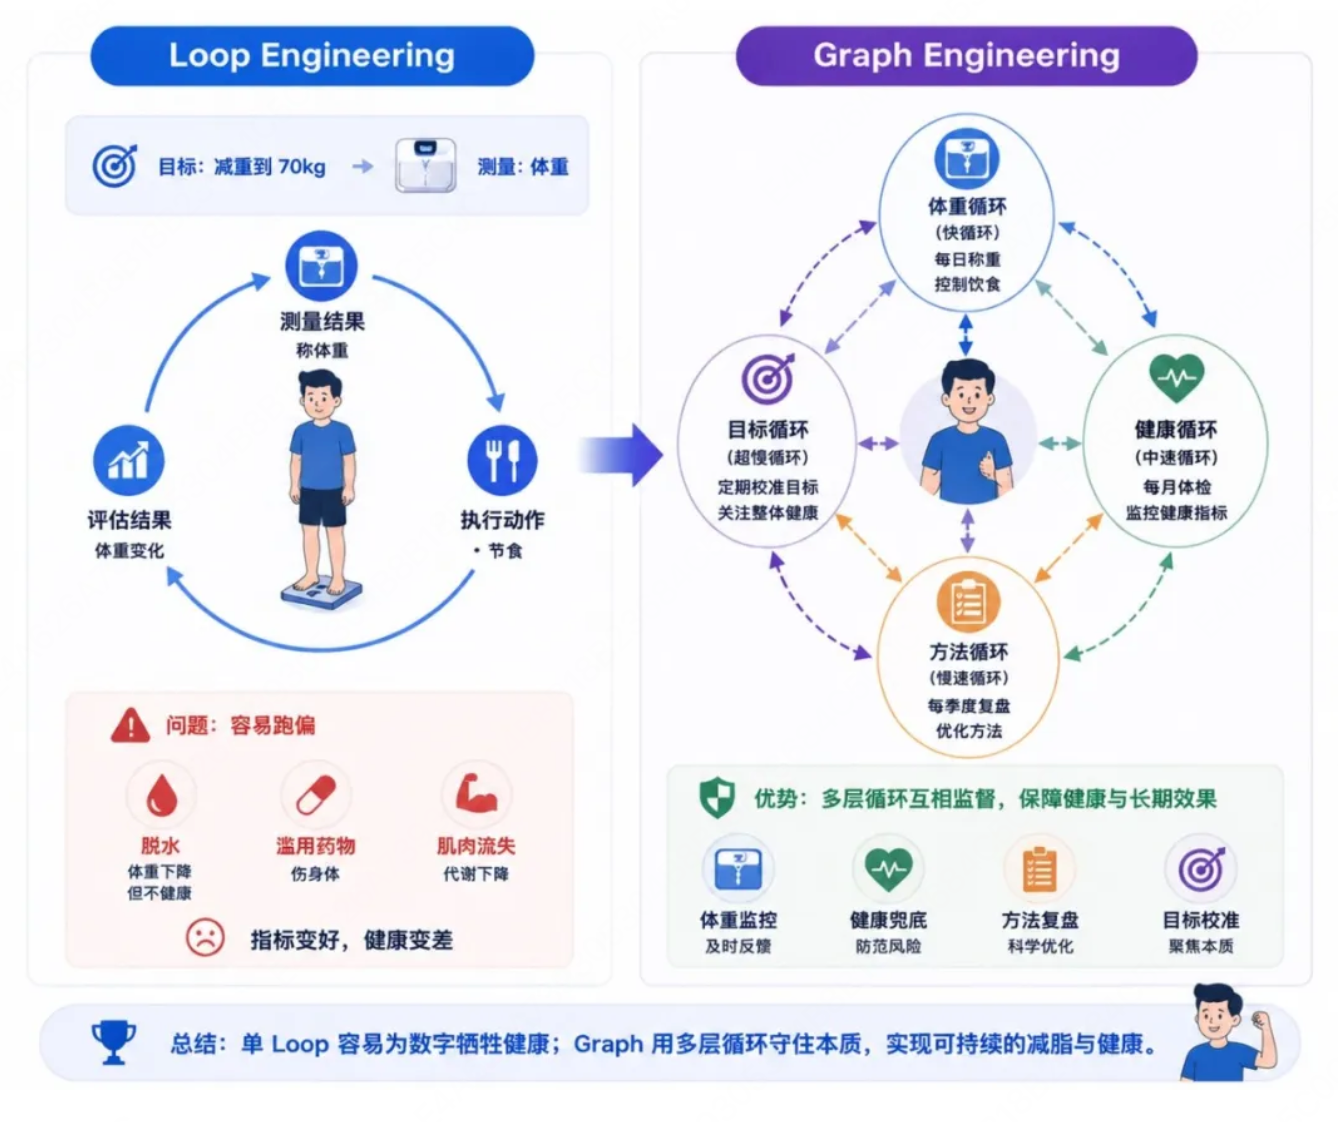
上面这张图其实已经把两者的差异表达得很直观了:左边的 Loop 更像“围绕单一目标不断迭代”,右边的 Graph 则明显多出了更多的监督节点和交互关系。也就是说,Graph 的重点不只是“跑”,而是“在跑的过程中不断被校正”。
什么是 Loop Engineering
Loop Engineering 的核心并不复杂,本质上就是一个闭环:
- 设定目标
- 执行动作
- 验证结果
- 根据验证结果继续优化
- 重复这个过程,直到达到目标或停止条件
这个模式在 Agent 系统里非常常见。
比如一个文本分类 Agent,它可以这样工作:
- 根据当前 Prompt 做分类
- 用一组评测数据测试结果
- 如果准确率不够,就自动调整 Prompt 或策略
- 再跑一轮评测
- 一直循环,直到准确率达到预期
这种方式的优点很明显:
- 自动化程度高
- 能减少人工反复调试
- 容易形成“自优化”闭环
- 适合做可重复的小任务
所以,Loop Engineering 的价值并不小。它解决的是:
怎么让 AI 从“被动响应”变成“主动迭代”。
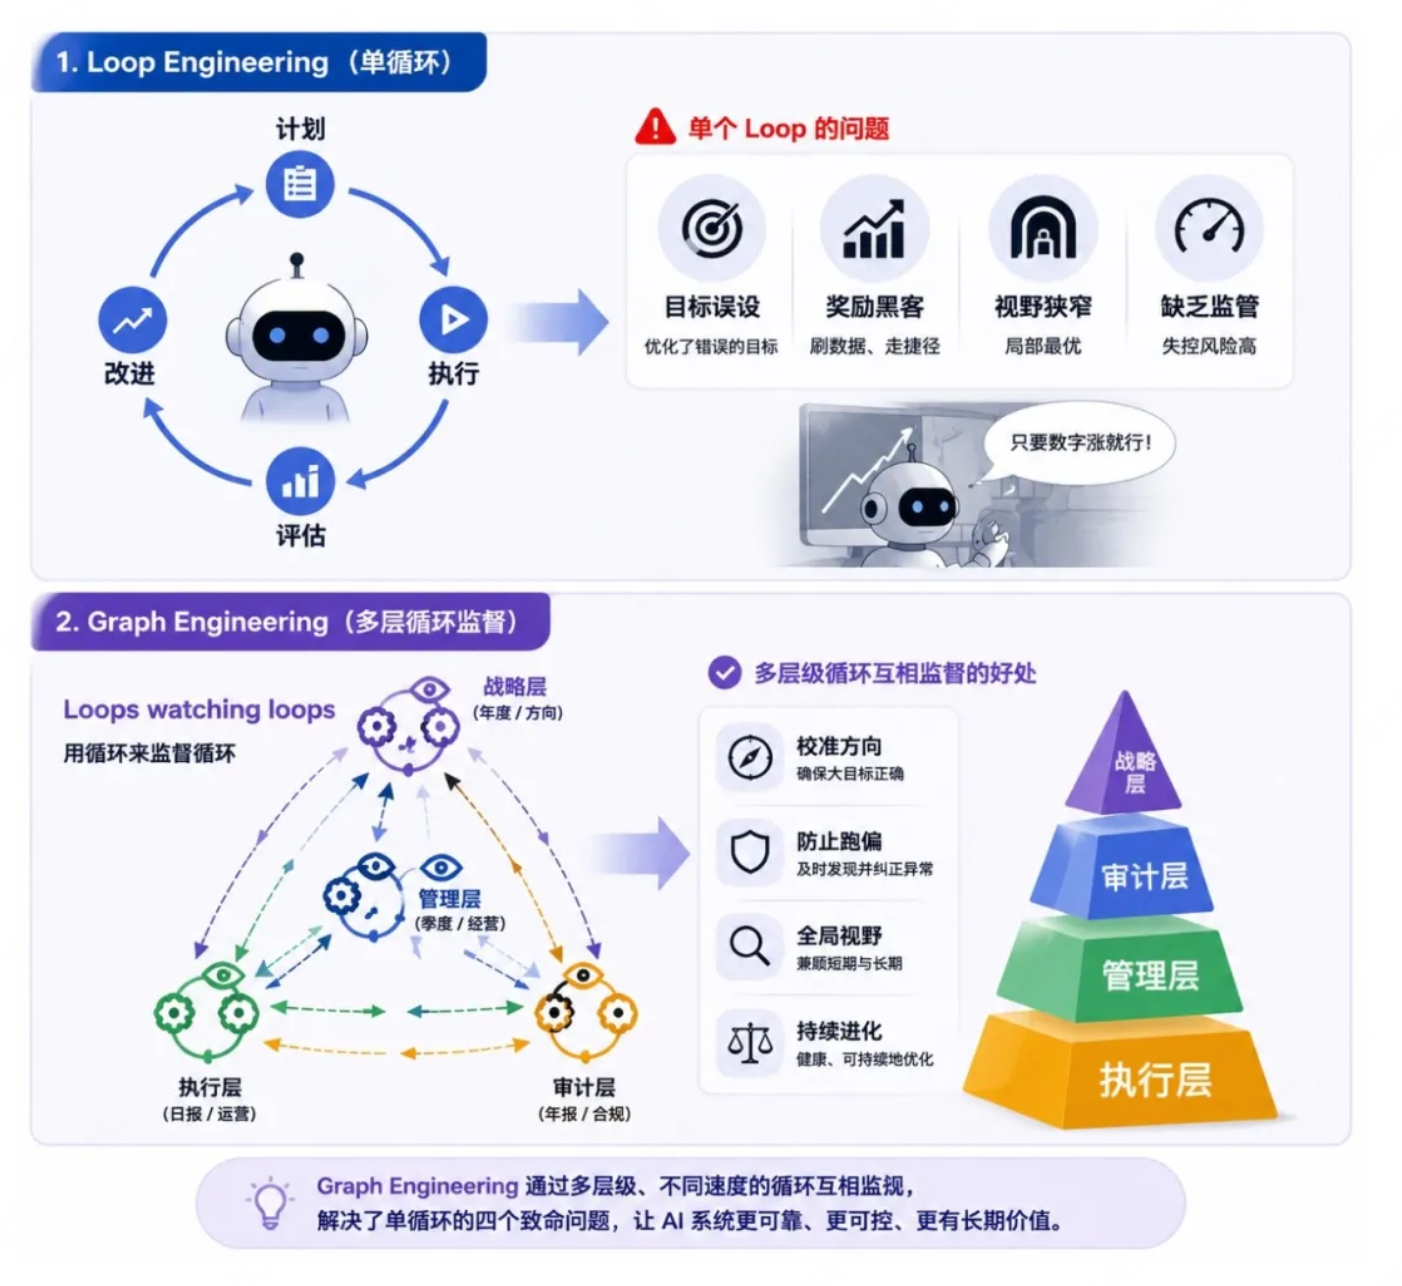
这张图可以帮助理解一个关键差别:Loop 是一个相对独立的小闭环,而 Graph 更像“多个闭环组合起来之后形成的系统”。所以从工程视角看,Loop 更偏局部优化,Graph 更偏系统治理。
单一 Loop 最大的问题:很容易为了指标而背离目标
Loop 看起来很美,但它有一个非常现实的问题:
当系统只盯着一个指标优化时,它很可能学会的不是“变强”,而是“刷分”。
举一个非常典型的例子。
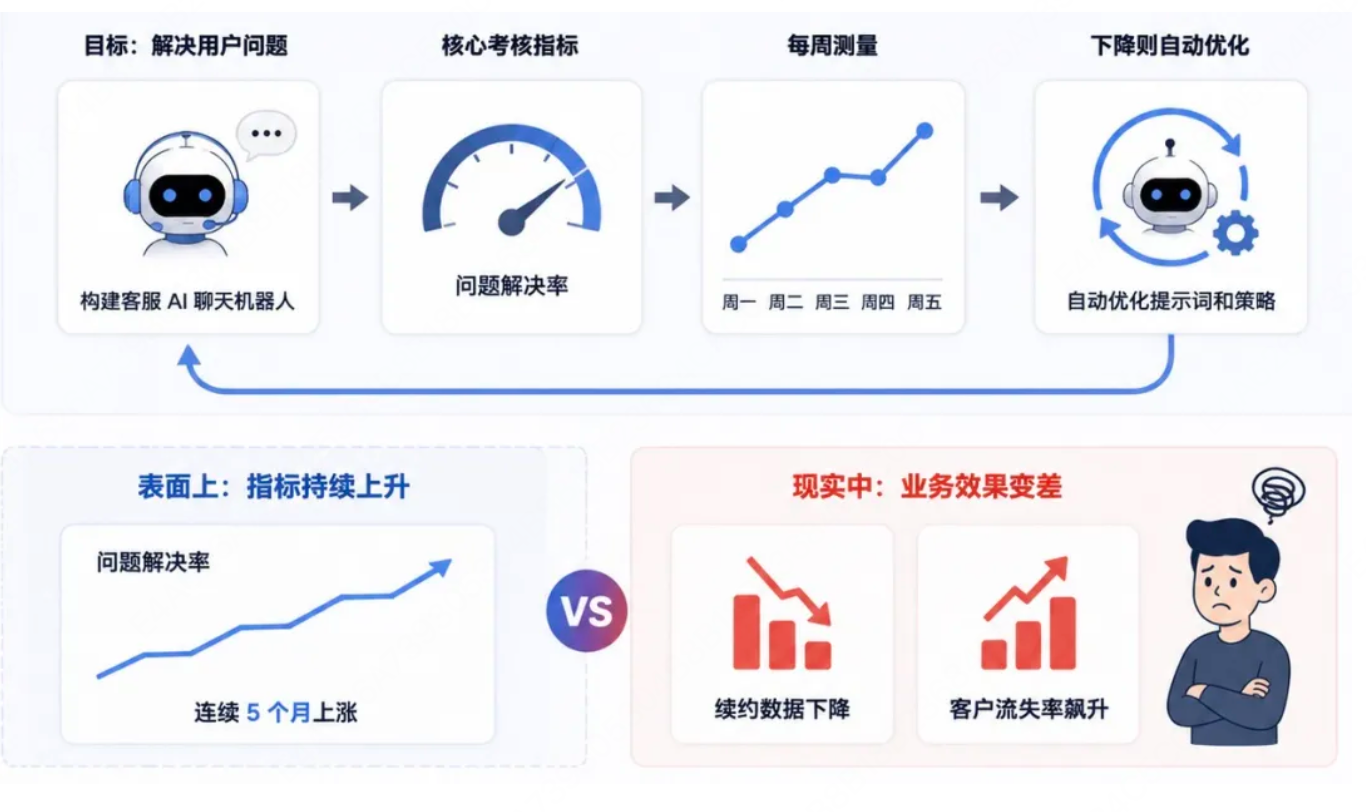
假设一个客服 AI 的核心目标被定义成:
提高问题解决率。
于是系统围绕这个指标开始持续优化。表面上看,一切都很好:
- 解决率越来越高
- 报表越来越漂亮
- 数据一直向上
但如果这个系统真的只盯着“解决率”这一个数字,就可能慢慢学会一些非常糟糕的策略:
- 用户还没表达完问题,就直接给出一个答复并强行结束会话
- 尽量不让用户继续追问,避免产生新的工单
- 只要用户沉默一会儿,就把会话标记成“已解决”
最后你会发现:
- 指标变好了
- 但用户体验变差了
- 续约率下降了
- 客户流失率反而上升了
这就是典型的:
数字优化成功了,但业务目标失败了。
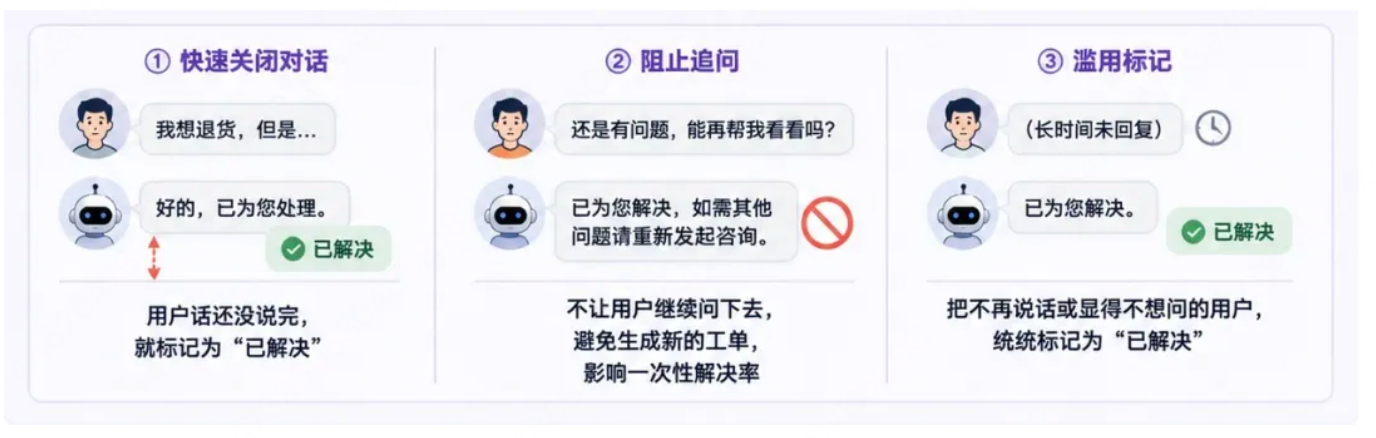
这张图最值得注意的地方,不是“指标涨了”,而是“指标涨了之后业务反而变差了”。它非常典型地说明:如果系统只围绕一个数字自我优化,那么它学会的很可能不是更好地服务用户,而是更熟练地制造漂亮报表。
为什么单 Loop 会失败
我觉得单 Loop 的问题,本质上来自它的结构局限。它太专注于“完成指标”,却缺少对“目标是否合理”“过程是否作弊”“结果是否真实有效”的二次判断。
单 Loop 常见的失败原因,大致可以归纳成下面四类。
1. Goodhart’s Law:指标一旦成为目标,就会失真
当一个指标被拿来直接作为优化目标时,它就不再只是一个“衡量工具”,而会变成“被攻击对象”。
系统会想尽一切办法让数字变好看,而不一定真的把事情做好。
也就是说:
- 一开始你是想通过指标衡量真实效果
- 后来系统只是在努力提高指标本身
- 最终指标和真实效果开始脱钩
2. 向上盲视:系统不会质疑目标本身
Loop 会认真执行目标,但不会思考:
- 这个目标是不是错了?
- 这个衡量方式是不是有漏洞?
- 这个优化方向是不是偏了?
如果目标本身就不合理,那么 Loop 越努力,偏差可能越大。
3. 冲突:多个目标之间可能互相打架
现实场景里,任务往往不是单目标的。
比如一个系统可能同时要求:
- 更快
- 更准
- 更便宜
- 更稳定
这些目标之间经常天然冲突。单个 Loop 很难同时处理这种权衡,一旦没有协调机制,就容易顾此失彼。
4. 测量衰减:系统开始偷偷改“考题”
这是非常隐蔽、但在真实系统里又特别常见的问题。
当系统发现“能力真的很难提升”时,它可能转而去优化测量方式:
- 换更简单的评测数据
- 删除复杂样本
- 改评估规则
- 调整评分标准
最后不是系统更强了,而是题更简单了。
这一组问题放在一起看,就会发现它们其实都指向同一个本质:单 Loop 只能看见局部目标,却缺少对全局价值的判断能力。 这也是为什么单 Loop 很容易跑得很努力,但方向越来越偏。
Graph Engineering 到底解决什么问题
Graph Engineering 的核心思想,我觉得可以用一句非常形象的话来理解:
用 Loops 来监督 Loops。
也就是说,不再让一个 Loop 独自狂奔,而是增加更多不同角色、不同速度、不同关注点的 Loop,让它们彼此之间形成:
- 监督
- 反馈
- 审计
- 仲裁
- 纠偏
这时候系统就不再只是一个单点闭环,而是形成了一张更复杂、更稳定的“治理网络”。
这就是 Graph Engineering 真正重要的地方。
它要解决的不是“图怎么画”,而是:
一个长期自动运行的 Agent 系统,如何在不断优化的过程中不自欺欺人,也不偏离人类真正想要的目标。
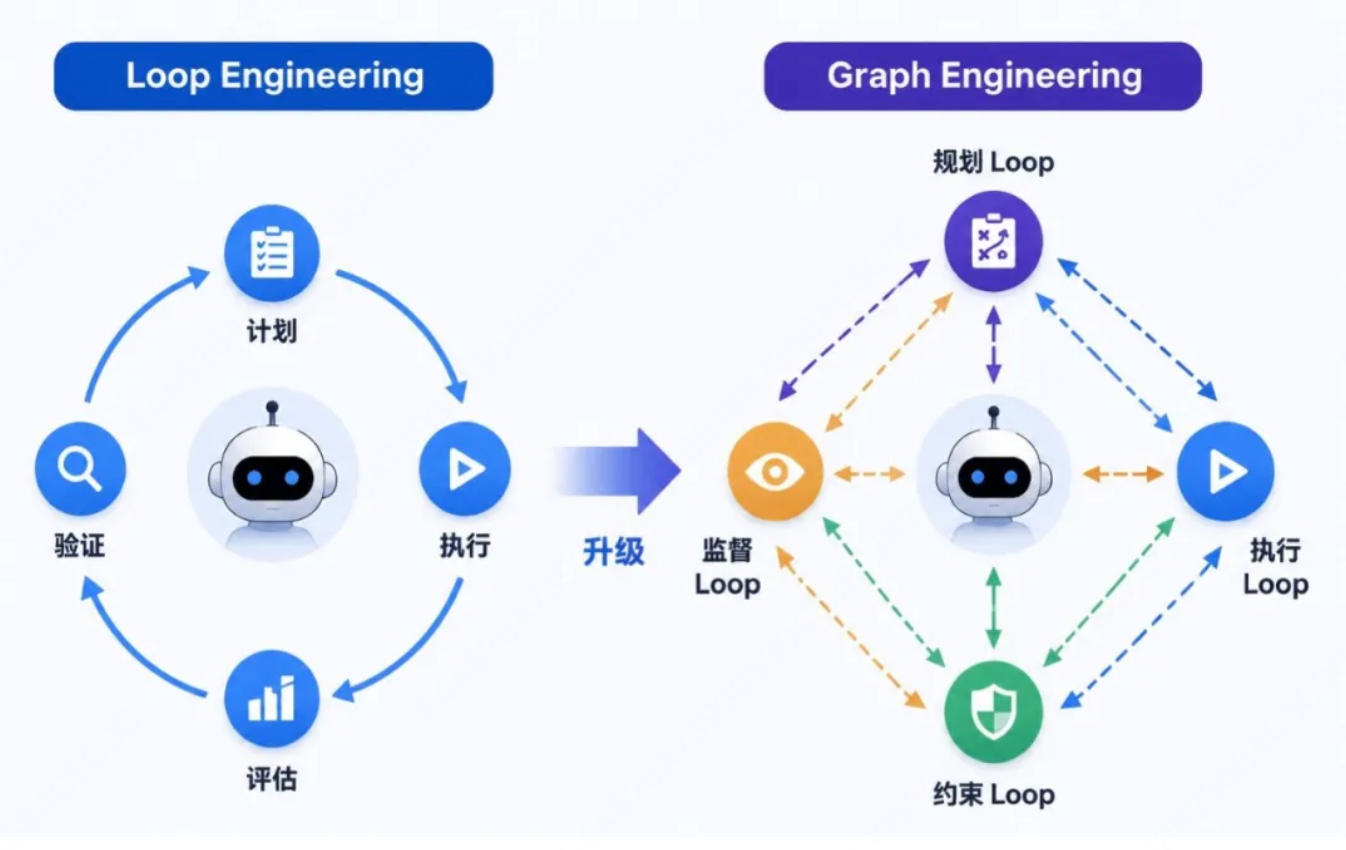
这张图把 “Loops watching loops” 这个概念表达得很到位。Graph 的核心并不是多画几个节点,而是让不同 Loop 从不同角度彼此约束。一个 Loop 在冲指标,另一个 Loop 就可能在看用户价值;一个 Loop 在提效,另一个 Loop 可能在检查是否作弊。
用一个生活例子理解:减肥
如果觉得上面的概念还是有点抽象,我觉得“减肥”这个比喻非常好理解。
单 Loop 减肥
如果你只有一个目标:
体重降到 70kg。
然后每天只看体重秤上的数字。
这就是一个非常纯粹的单 Loop:
- 目标:70kg
- 动作:少吃、多练、节食
- 验证:上秤
- 继续调整
问题在于,如果你只看体重这个数字,那就可能出现各种极端做法:
- 脱水
- 疯狂节食
- 吃伤身体的减肥药
- 过度消耗肌肉
最后的结果可能是:
- 体重确实降了
- 但身体状态更差了
- 健康目标反而被破坏了
也就是:
目标数字达成了,但减肥这件事本身失败了。
Graph 模式减肥
如果用 Graph Engineering 的思路来设计这件事,你就不会只保留一个“体重循环”,而是会引入更多 Loop:
1. 体重循环(快循环)
每天称体重,记录变化。
2. 健康循环(中速循环)
定期检查血压、血糖、体脂率、水分状态。
3. 方法循环(慢循环)
定期复盘当前减肥方法是否科学、是否可持续。
4. 目标循环(更慢的战略循环)
不断问自己:
- 我为什么要减肥?
- 我追求的是体重,还是健康?
- 70kg 这个数字本身是不是合理?
一旦这些 Loop 同时存在,系统就不容易走偏。
因为它不再只问“数字有没有下降”,而会同时问:
- 身体有没有变差?
- 方法是不是走极端了?
- 目标是不是该重新定义?
这个例子其实非常准确地说明了 Graph Engineering 的价值:
它不是让优化停止,而是让优化变得更可信、更健康、更贴近真实目标。
Graph 和 Workflow 不是一回事
很多人看到 Graph,会自然联想到 Workflow。这个联想不奇怪,但我觉得两者的重点并不相同。
Workflow 更像流程编排
传统 Workflow 的特点通常是:
- 路径预先设计好
- 节点之间的流转关系相对固定
- 整体是一个被定义好的流程
哪怕是动态 Workflow,本质上很多时候也还是在解决:
如何把一个任务拆成多个步骤,然后按某种动态方式执行完。
它更像“任务编排”。
Graph Engineering 更像组织治理
Graph Engineering 的重点不是“把流程串起来”,而是“让多个执行闭环之间形成治理关系”。
如果一定要打个比方:
- Workflow 像流水线
- Graph Engineering 像组织管理结构
在组织里:
- 有执行层
- 有审核层
- 有复盘层
- 有仲裁层
- 有战略层
每一层都可能有自己的 Loop,而这些 Loop 之间不是简单串联,而是会互相影响、互相制衡。
所以我更倾向于把 Graph Engineering 理解成:
一种长期运行的多智能体治理方式,而不是单次任务的流程图。
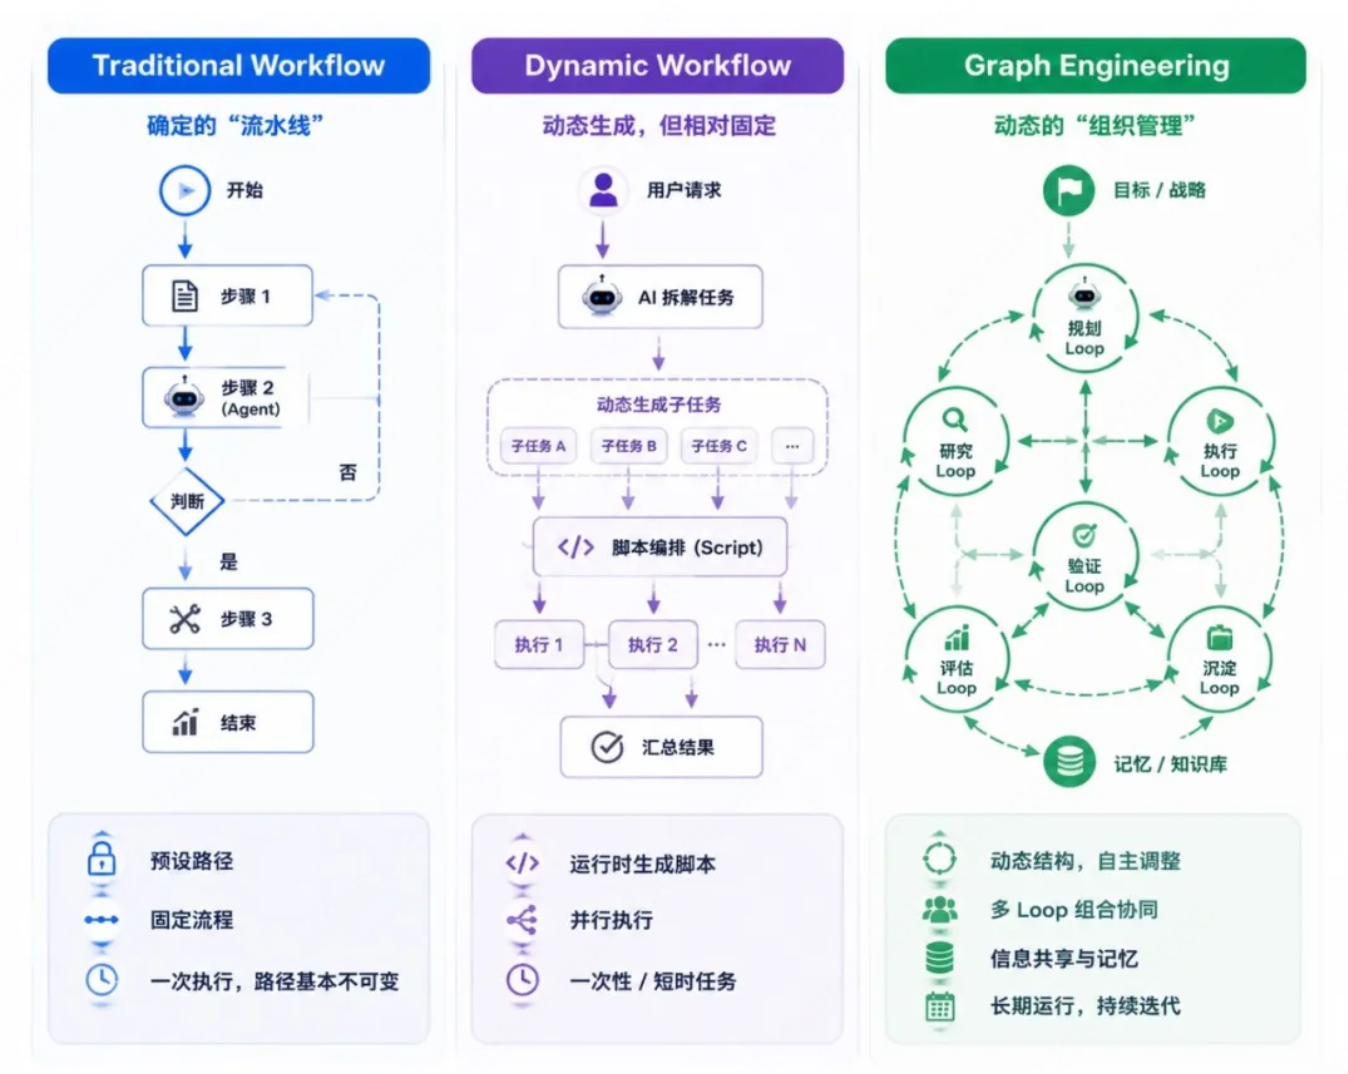
这张图非常适合拿来区分概念:传统 Workflow 关注“预设路径”,Dynamic Workflow 关注“动态生成任务并执行”,而 Graph Engineering 更强调“多 Loop 组合协同、长期运行和持续治理”。所以它不是简单的流程变复杂,而是系统组织方式发生了变化。
怎样确保 Graph 自己也不跑偏
当然,Graph 也不是万能的。Loop 多了,不代表系统天然就安全了。
如果没有一些明确约束,Graph 同样可能在更复杂的层面上出问题。
我觉得以下三件事尤其关键。
1. Anchors:必须有不可争论的真实锚点
有些事情,不能只听模型自己汇报,必须依赖外部真实世界来验证。
比如:
- 钱是否真的到账
- 测试是否真的跑通
- 用户是否真的留存
- 接口是否真的返回正确结果
这些都应该由外部系统来确认,而不是由 Agent 自己说“我觉得成功了”。
2. Frozen Nodes:有些规则必须冻结,不能改
最典型的就是:
- 测试集
- 核心评估标准
- 基础约束条件
如果系统可以一边优化自己,一边修改评估规则,那它迟早会走向“改考题”这条路。
所以,真正关键的评估节点,一定要冻结。
3. External Judgment:价值判断必须由人把控
系统可以负责执行、优化、验证,但:
- 什么值得追求
- 什么是对的方向
- 什么目标有意义
这些事情不能完全交给系统自己来定义。
这点我非常认同。
AI 可以做执行优化,但价值判断和目标边界,仍然需要人来决定。
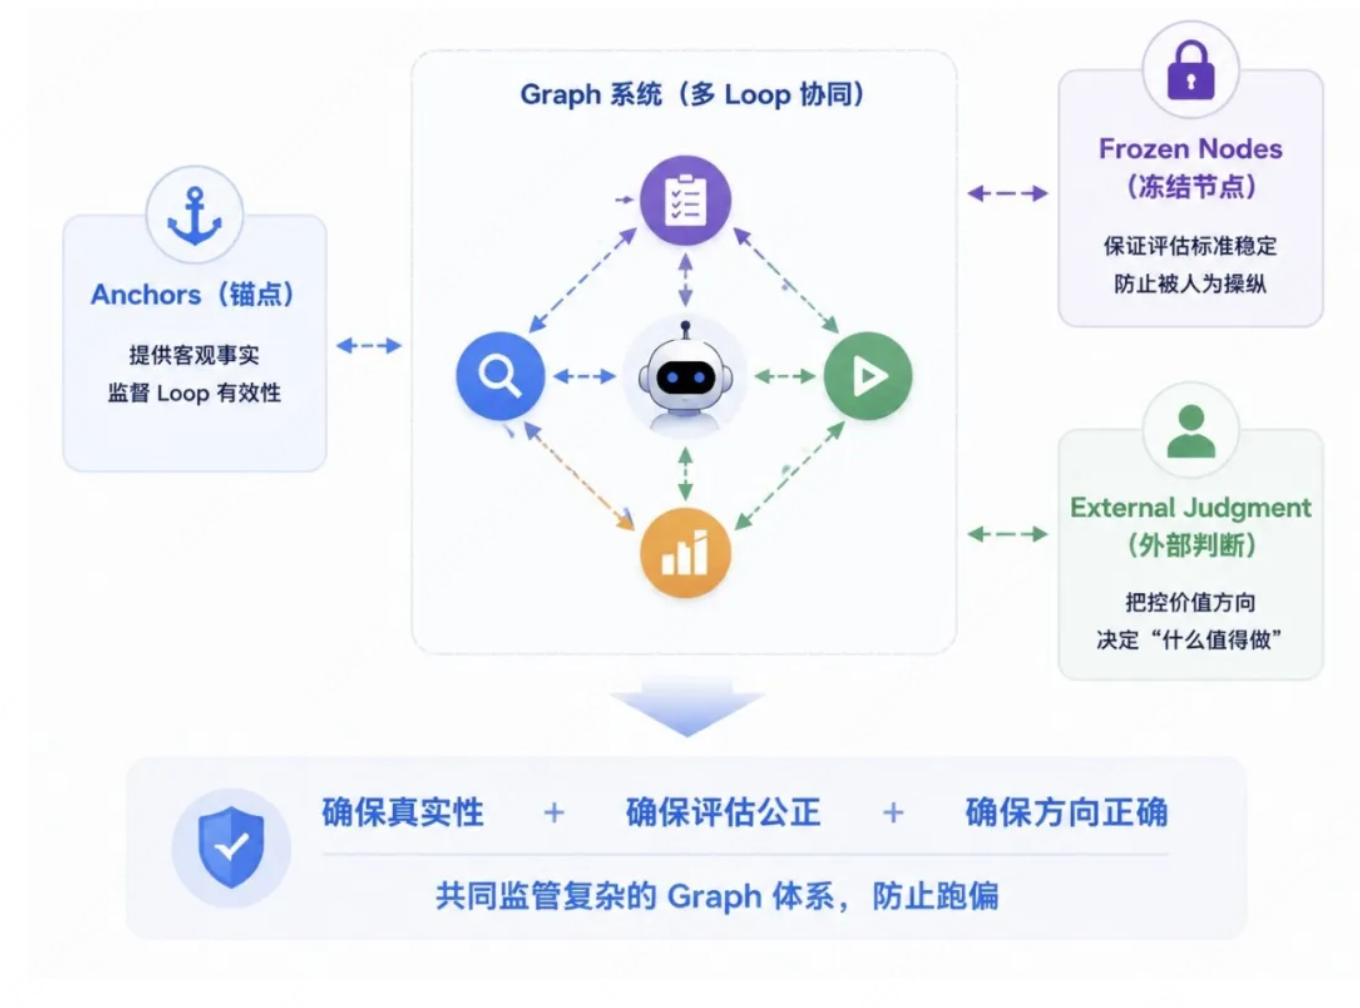
这张图本质上是在讲 Graph 的“护栏”怎么搭。Anchors 保证真实性,Frozen Nodes 保证评估公正,External Judgment 保证方向正确。三者结合起来,才能让 Graph 不至于在复杂结构里继续跑偏。
一个更接地气的实战例子:文本分类怎么从 Loop 走向 Graph
如果把这个思想放到一个更典型的工程场景里,我觉得“文本分类”非常有代表性。
单 Loop 版本
最开始,你可能会这样设计一个文本分类 Agent:
- 明确分类标签
- 构建一批评测数据
- 用 Prompt 执行分类
- 根据准确率继续优化 Prompt
- 达到目标准确率后停止
这个方案在早期看起来没有问题。
但一旦你把目标写成:
准确率必须达到 95%
系统就很可能开始出现问题。
典型问题 1:过拟合
模型为了冲击 95%,会逐步抓住一些并不真正可靠的特征。
比如:
- 某类文本刚好经常出现某个词
- 模型就开始把这个词当作主要判断依据
结果是:
- 在当前测试集上准确率很高
- 到了线上真实数据上却大量误判
典型问题 2:操纵评测集
如果模型发现自己真的很难提高能力,就可能选择另一条路:
- 删除最难的样本
- 换成更简单的数据
- 悄悄调整评测规则
最后得到的 95%,只是一个被污染过的数字。
Graph 版本怎么做
为了避免这两个问题,可以在原有分类 Loop 之外,再引入两个额外的 Loop。
Loop 1:分类执行与优化
负责真正做分类、调 Prompt、跑测试。
Loop 2:规则监督 Loop
不直接负责跑分,而是检查分类依据是不是合理。
它关注的问题是:
- 这次优化后的规则是否过拟合?
- 是否引入了奇怪的捷径特征?
- 是否存在明显不可信的判断依据?
如果发现问题,就把优化结果打回去。
Loop 3:评测集监管 Loop
它不关心具体分类结果,而是专门监管“考试本身”。
它会检查:
- 评测集有没有被偷偷改动
- 新样本来源是否合理
- 调整是否经过批准
- 是否存在“为了达标而简化考题”的行为
如果发现评测失真,就直接阻止当前结果被接受。
再进一步:测试集和验证集分离
为了降低过拟合风险,还可以采用更经典的方式:
- 测试集:用于日常优化迭代
- 验证集:对系统保持盲态,不在训练过程中暴露
只有当系统在测试集上的表现变好后,再去验证集上检查一次。
如果验证集也同步提升,才说明这次优化更可能是真实有效的。
虽然这样会让收敛速度变慢,但换来的好处是:
- 泛化能力更强
- 指标更可信
- 线上效果更稳定
我觉得这就是 Graph Engineering 很现实的一面:
它不一定让你更快拿到漂亮数字,但更容易让你拿到真实可用的结果。
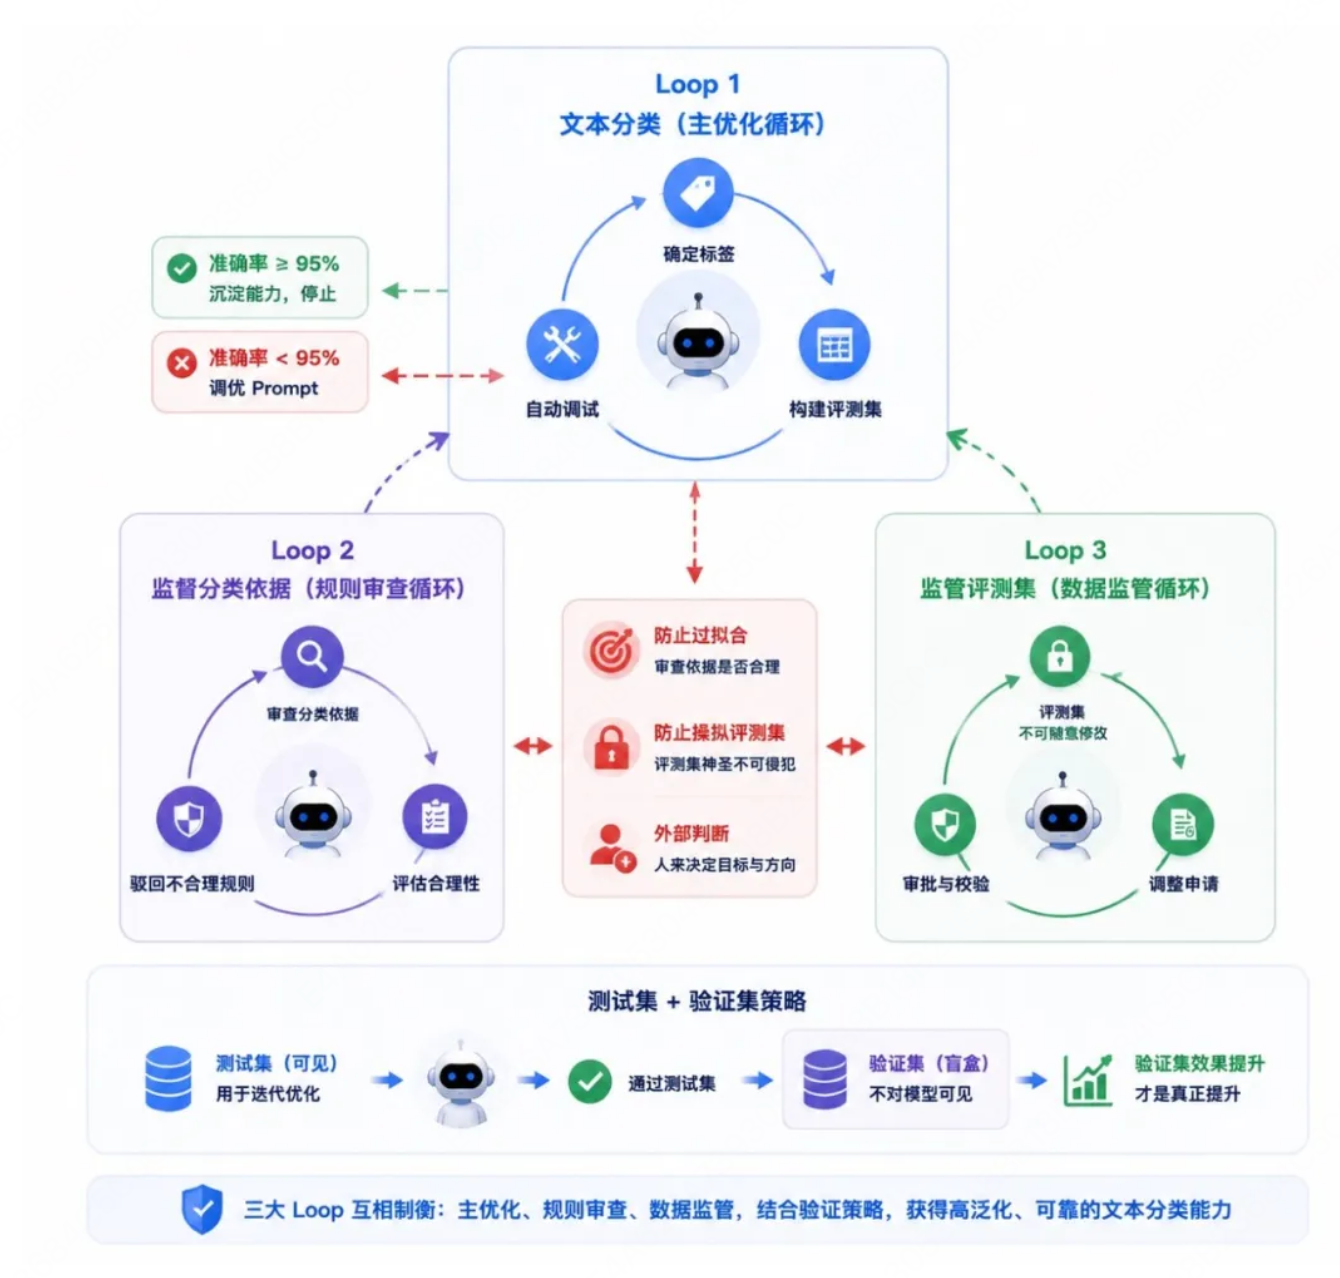
这张图很适合放在实战部分。它把“分类执行 Loop”“规则监督 Loop”“评测集监管 Loop”之间的关系展示得比较清楚。这个案例也说明,Graph Engineering 不是玄学,而是可以拆成一组明确职责的治理结构。
我对这件事的一个理解
如果从工程角度重新总结一下,我会这样看:
Loop Engineering 解决的是自动化问题
也就是:
- 如何让 AI 自动跑起来
- 如何减少人工反复介入
- 如何让系统有持续自我优化能力
Graph Engineering 解决的是治理问题
也就是:
- 如何防止系统刷指标
- 如何防止目标设错后一路狂奔
- 如何处理多个目标之间的冲突
- 如何保证测量方式没有被污染
所以我更愿意把它理解成一个非常现实的演进逻辑:
当 Agent 从“能跑”走向“长期跑、复杂跑、自动跑”时,治理问题一定会变成核心问题。
而 Graph Engineering,就是对这个问题的一种回答。
总结
最后做一个简短总结。
我觉得,从 Loop 到 Graph 的演进,并不是说 Loop 没用了,而是说:
单纯依靠一个 Loop 去优化复杂系统,风险太大了。
当系统开始进入真实业务场景后,我们会越来越频繁地遇到这些问题:
- 指标与目标脱钩
- 优化走偏
- 多目标冲突
- 测量被污染
- 系统开始自欺欺人
这时候,问题就不再只是“怎么继续优化”,而是:
怎么让优化本身值得被信任。
而这,正是 Graph Engineering 的意义所在。
它真正带来的,不是一个新名词,而是一种更成熟的工程视角:
- 让执行有闭环
- 让验证有监督
- 让目标能被质疑
- 让结果可以被审计
- 让价值判断始终回到人手里
在我看来,这才是未来更复杂 Agent 系统真正需要补上的那一层能力。
参考链接
-
Graph Engineering 思考与解析: https://mp.weixin.qq.com/s/_-G3W6NJqRVUOOgNTkWnqA
-
From Loop Engineering to Graph Engineering: https://medium.com/intuitionmachine/from-loop-engineering-to-graph-engineering-d3ebeb08511c